O que é um agente de IA?
Os três componentes de um agente de IA, o loop ReAct que os põe em movimento e o harness.
 Wenderson Melo16 min de leitura
Agente de IA virou o termo do momento. Todo produto com um LLM dentro ganhou o rótulo, e cada empresa define a palavra de um jeito. A pergunta “o que é um agente?” circula na computação há décadas e até hoje não tem uma “definição definida”.1 Este texto não entra nessa disputa. Ele responde à pergunta do título pelo lado prático: do que um agente é feito hoje e como as peças funcionam juntas.
A resposta que eu uso cabe numa fórmula: agente = LLM + contexto + ferramentas, e tudo isso roda dentro de um loop.2 Vou passar por cada componente, depois pelo loop ReAct que os liga, e pelo nome que se dá a tudo o que não é o modelo, o harness. No fim, uso essa forma de entender um agente no ChatGPT e no Claude.
Três componentes e um loop
A fórmula é agente = LLM + contexto + ferramentas, e ela descreve só o que está dentro dos limites do agente, sem incluir o ambiente com que ele interage.2 Os três componentes podem ser traduzidos metaforicamente como cérebro, olhos e mãos e pés, e é a imagem de que eu mais gosto. O contexto são os olhos: tudo o que o modelo enxerga naquela chamada. As ferramentas são as mãos e os pés: o único jeito de o agente mudar o mundo. O LLM é o cérebro, o raciocínio que decide o que fazer a partir do que vê.
Nenhum dos três é agente sozinho. O que os transforma em agente é um loop: montar o contexto, chamar o modelo, executar o que ele pediu, devolver o resultado e começar de novo. Nessa montagem, o modelo é só um dos componentes. Tudo o mais, o contexto, as ferramentas e o próprio loop, tem um nome: harness. Dá para escrever a mesma fórmula de outro jeito: agente = LLM + harness.2 O diagrama abaixo representa bem isso.
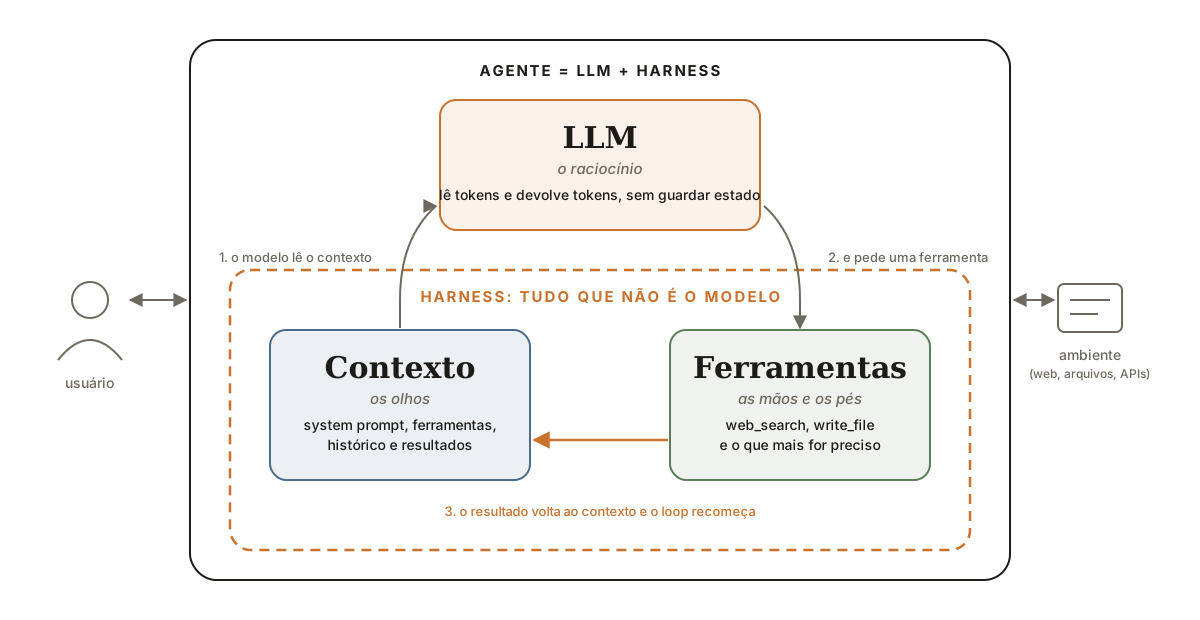
A metáfora tem limites. Os “olhos” aqui só veem o que o harness coloca na frente deles, e o “cérebro” é a predição do próximo token. Mesmo assim ela ajuda a separar responsabilidades, e é nessa ordem que vou passar por cada componente.
Contexto: os olhos do agente
O primeiro componente é o contexto. Um LLM não guarda nada entre uma chamada e a outra: ele é stateless.3 Tudo o que o modelo precisa saber sobre a tarefa em andamento tem de chegar de novo a cada chamada. Esse texto é a janela de contexto: os olhos do agente. Tudo o que ele enxerga do ambiente e da própria tarefa passa por ali.
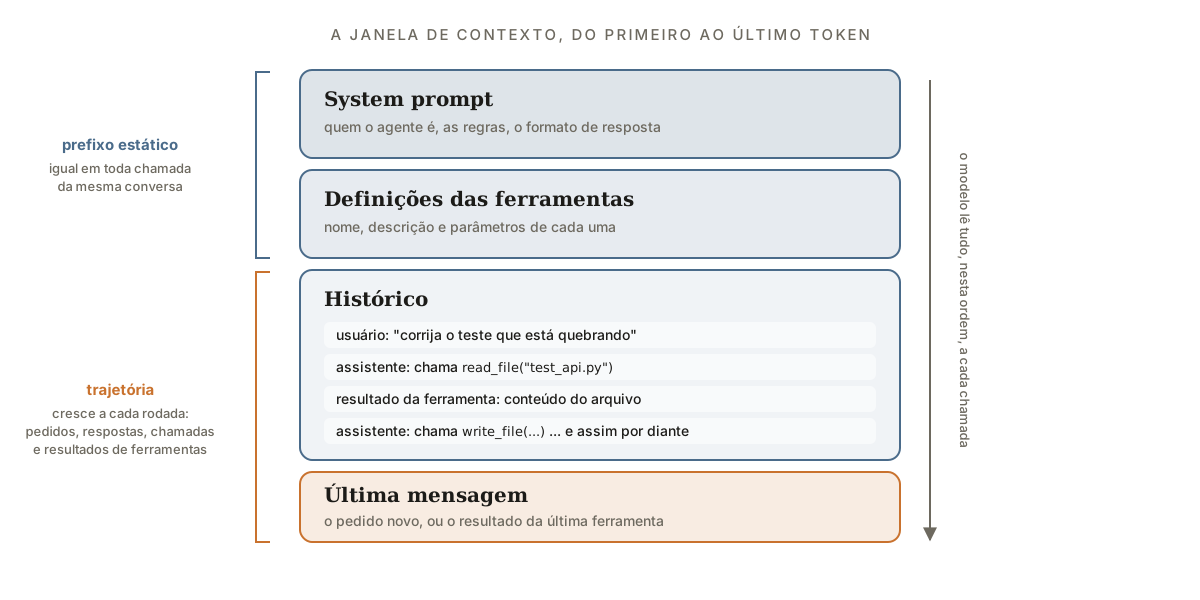
Do ponto de vista da API, o contexto de cada chamada tem cinco partes.2 A primeira é o system prompt: quem o agente é, as regras que segue e o formato em que deve responder. A segunda é o conjunto de definições das ferramentas. Cada uma tem um nome, uma descrição em linguagem natural e os parâmetros que aceita, em geral descritos em JSON Schema. Essas duas formam o prefixo estático, que não muda ao longo da conversa.
As outras três formam o histórico, que cresce a cada rodada: as mensagens do usuário, as respostas do modelo (o raciocínio, o texto e as chamadas de ferramenta) e os resultados que cada ferramenta devolveu. Esse histórico também é chamado de trajetória, o que dá outra forma da conta: contexto = prefixo estático + trajetória.2
Para o modelo, essas partes não são estruturas separadas. O harness concatena tudo numa única sequência de tokens, e o modelo lê essa sequência do zero, do primeiro ao último token, a cada chamada, antes de produzir a continuação. Nada disso persiste dentro do modelo. Quem guarda o histórico entre uma chamada e outra é o harness, e é ele que o reenvia inteiro na chamada seguinte.
O diagrama abaixo mostra as partes na ordem em que o modelo as lê.
Nem toda parte pesa igual. Sem as definições de ferramentas, o agente não consegue chamar nenhuma, mas não avisa: responde com confiança, com dados que vêm da memória do treino e não de uma observação. Sem os resultados das ferramentas, ele age às cegas e repete tentativas até esgotar o limite de iterações. Sem o raciocínio, as decisões ficam inconsistentes. Sem o histórico, ele repete operações já feitas.2
Escolher o que entra, portanto, é a metade mais importante do trabalho. O modelo tem um “orçamento de atenção”: quanto mais tokens na janela, pior ele recupera uma informação específica dela.4 Contexto é um recurso finito. Como organizar esse recurso, com cache e compactação, fica para outro texto.
Ferramentas: as mãos e os pés
Um LLM só produz texto. Para que o agente faça algo no mundo, alguém precisa transformar parte desse texto em ação, e esse é o papel das ferramentas. Sozinho, o modelo não busca na internet nem chama uma API.5 Uma ferramenta é uma função que o harness expõe ao modelo: recebe argumentos, faz algo no ambiente e devolve um resultado em texto.
O mecanismo é o mesmo em qualquer provedor e se chama tool calling. O harness coloca no contexto a definição de cada ferramenta: nome, descrição em linguagem natural e esquema dos parâmetros. O modelo lê essas definições junto com o resto do contexto e, quando decide usar uma, não executa nada: em vez de responder em texto, ele devolve uma chamada estruturada, com o nome da ferramenta e os argumentos preenchidos. Quem recebe essa chamada e roda a função é o harness.
Do lado do harness, uma chamada de ferramenta passa por quatro etapas: validar os argumentos contra o esquema, executar a função, tratar o erro se houver e anexar o resultado ao contexto como mais um trecho de texto.2 Na chamada seguinte, o modelo lê esse resultado e decide o próximo passo. A chamada que o modelo escreveu é só um pedido. O que aconteceu de fato é o que o harness devolveu.
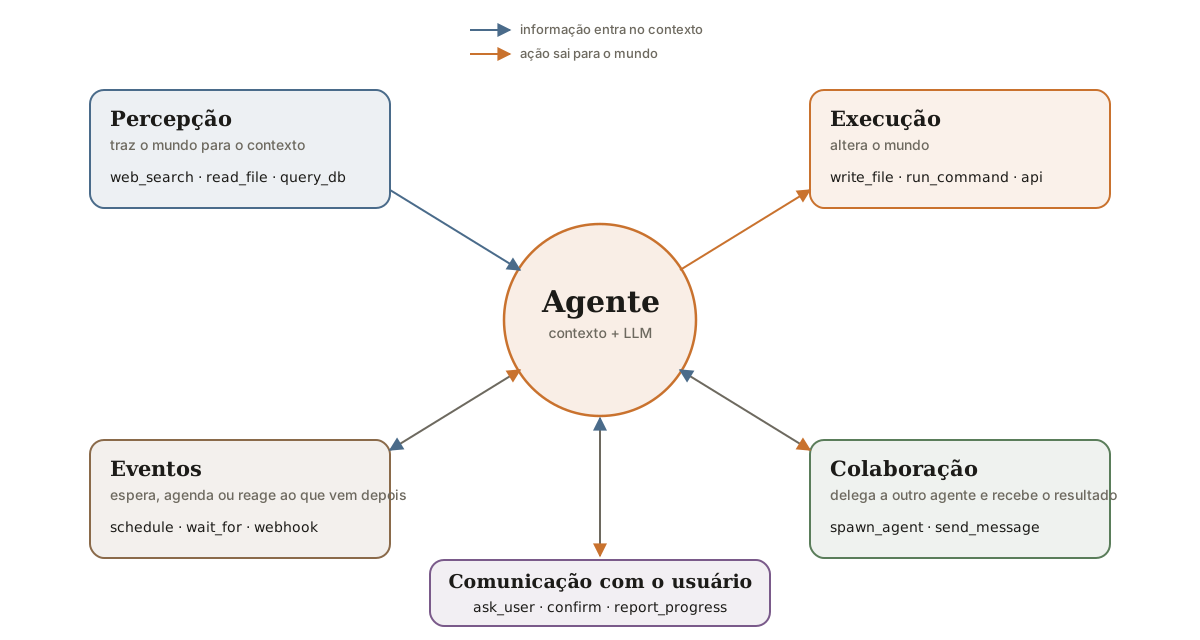
As ferramentas se dividem em cinco tipos, pela direção da interação do agente com o mundo.2
- Percepção: trazem informação do mundo para o contexto.
web_search,read_file, uma consulta a um banco, uma captura da tela. - Execução: alteram o mundo.
write_file, rodar um comando, chamar uma API que cria um registro. - Colaboração: delegam uma tarefa a outro agente ou subagente e recebem o resultado quando ele termina, ou pedem a confirmação de um humano num ponto de decisão.
- Comunicação com o usuário: levam informação ao usuário. Avisar o andamento, entregar o resultado, mandar uma notificação, por chat, e-mail ou mensagem.
- Eventos: deixam o agente agendar, esperar ou reagir a algo que acontece depois. Um timer, um webhook, um “me acorde quando o build terminar”.
As quatro primeiras são chamadas pelo próprio agente. As ferramentas de eventos invertem a direção: o agente registra o interesse, e é o ambiente que o aciona depois. Sem elas, um agente só responde quando alguém inicia a conversa.2 O diagrama abaixo coloca o agente no centro e as cinco categorias ao redor dele, como canais de entrada e saída.
Veja como isso funciona em duas ferramentas comuns. Em web_search, entra uma string de consulta e sai uma lista de títulos, URLs e trechos, que o modelo lê como qualquer outro texto do contexto. Nada no ambiente muda, e um erro custa pouco: o agente busca de novo com outros termos. Em write_file, entra um caminho e um conteúdo e sai uma confirmação curta, mas o efeito colateral é real: o arquivo em disco foi sobrescrito. Por isso essa ferramenta pede mais cuidado, e é comum o harness pedir confirmação ao usuário antes de executar, rodar a chamada em um sandbox ou registrar tudo em log. A recomendação geral é o menor espaço de ação que resolva a tarefa.3
A descrição da ferramenta é a única coisa que o modelo lê para decidir se a usa e como. Por isso ela merece o mesmo cuidado de uma documentação para um colega novo: dizer o que a ferramenta faz, quando usar e o que devolve. Os nomes dos parâmetros também importam (user_id diz mais que user), e poucas ferramentas bem escolhidas funcionam melhor do que um wrapper para cada endpoint da API.6 No fim, uma ferramenta é um contrato entre dois lados que funcionam de jeitos diferentes: um sistema determinístico, que sempre responde do mesmo jeito, e um modelo que decide de forma probabilística quando e como chamar. A definição bem escrita é o que faz esse contrato funcionar.6
LLM: o raciocínio, sem memória
Depois do contexto e das ferramentas, sobra o modelo. O LLM é só o modelo treinado: um conjunto de pesos congelados que recebe uma sequência de tokens e devolve uma distribuição de probabilidade sobre o próximo token.7 Quem escolhe um token dessa distribuição, acrescenta à sequência e chama o modelo de novo até o fim da resposta é o motor de inferência, do lado de quem serve o modelo. O harness do agente não participa disso: ele chama a API e recebe o texto pronto.
Sobre a arquitetura, o básico. Os modelos atuais são Transformers, uma arquitetura proposta em 2017 que segue como padrão.8 As variações ficam por dentro: a maioria dos modelos grandes de hoje é do tipo Mixture of Experts, que ativa só uma parte dos pesos a cada token, e alguns misturam camadas de atenção com mecanismos mais baratos para contextos longos. O mecanismo central é a atenção: para produzir cada token, o modelo pesa o quanto cada token anterior da sequência importa e combina essas contribuições. Daí uma consequência prática: a sequência que entra, a janela de contexto, é o único mundo que o modelo vê. O que está na janela influencia a resposta. O que ficou fora não existe para aquela chamada.
Sozinho, o modelo é reativo: produz uma saída quando alguém pede e não persegue objetivo nenhum por conta própria.5 Ele também não decide o que pode ver, o que pode fazer nem onde guardar o que precisa durar. E tem limites próprios: alucina, tem uma janela finita e não retém nada de uma sessão para a outra.9 Por isso o modelo é necessário, mas não suficiente. O que precisa persistir vai para fora, em arquivo ou banco, e volta ao contexto pelas mãos do harness.
Nem todo modelo serve para esse papel. Para rodar o loop, ele precisa de suporte a tool calling, isto é, ter sido treinado para devolver chamadas de ferramenta num formato estruturado, e a structured output, respostas em JSON que seguem um esquema. Sem isso, o harness tem de extrair a chamada de um texto livre, e cada erro de formato vira uma falha do agente. A qualidade do tool calling varia bastante entre modelos, e o jeito de saber é testar no seu caso.2 Também ajuda que o modelo tenha capacidade de raciocínio, porque o loop pede decisões em várias etapas.2
No fim, o LLM se comporta como uma função sem estado: recebe texto, devolve texto e não guarda nada entre uma chamada e outra. Para agir, alguém precisa montar o contexto, executar o que ele pede e chamá-lo de novo.
O loop ReAct: quem junta os componentes
Até aqui descrevi três componentes parados. O contexto mostra, as ferramentas agem, o LLM raciocina. Nenhum deles faz nada sozinho. O que põe os três em movimento é um loop, e o nome mais conhecido desse loop é ReAct (não confundir com o React, a biblioteca de interfaces).
O ReAct foi proposto em 2022. A ideia é fazer o modelo gerar “tanto traços de raciocínio quanto ações específicas da tarefa, de forma intercalada”.10 Em vez de responder de uma vez, o modelo pensa um pouco, age, olha o resultado e pensa de novo.
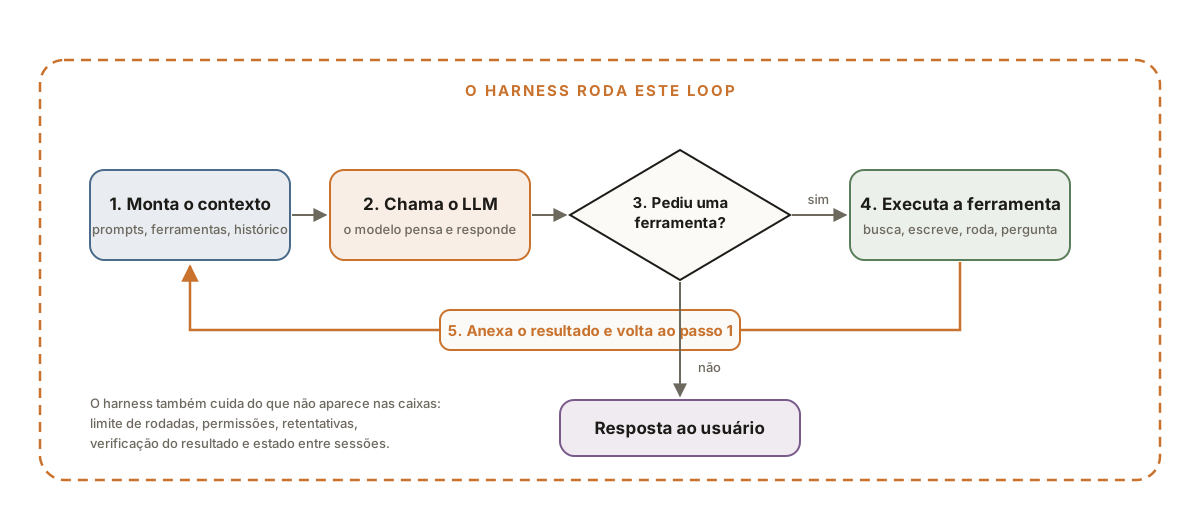
Do lado do harness, o loop funciona assim. Ele monta o contexto: system prompt, definições das ferramentas, histórico da conversa e o pedido do usuário. Chama o modelo e lê a resposta. Se a resposta contém uma chamada de ferramenta, executa a ferramenta, anexa o resultado ao contexto e chama o modelo de novo. Se não contém, a rodada termina e o texto vai para o usuário.2
Um loop desses precisa saber quando parar, senão o agente roda até esgotar o orçamento ou continua a trabalhar numa tarefa que já acabou.11 A condição de saída mais simples já apareceu acima: o modelo responde sem pedir ferramenta. As outras três são chamar uma ferramenta de resposta final, um erro irrecuperável ou o número máximo de rodadas.2
O ReAct não é o único desenho de loop, mas é o núcleo dos outros. Há variações que planejam antes de agir (o modelo escreve um plano e executa os passos), que refletem sobre as tentativas anteriores antes de tentar de novo (Reflexion)12, que exploram vários caminhos de raciocínio e escolhem o melhor (Tree of Thoughts)13 e que separam quem propõe de quem revisa, para o modelo não aprovar o próprio trabalho.2 No outro extremo ficam os workflows, em que o caminho é fixado em código e o modelo só decide dentro de cada etapa: encadear prompts, rotear, paralelizar, um orquestrador com trabalhadores, um avaliador com um otimizador.11 Na prática, quase tudo é variação do ReAct ou uma camada por cima dele.
O diagrama abaixo mostra uma rodada completa, com a bifurcação que decide se o loop continua ou encerra.
Harness: o agente menos o LLM
Nesse loop, o modelo só produz texto. Montar o contexto, reconhecer a chamada de ferramenta, executar, anexar o resultado e decidir quando parar é trabalho do harness. O nome é uma metáfora: harness são os arreios de um cavalo. Eles não servem para conter a força do animal, e sim para direcioná-la. O modelo é o cavalo; o harness é o que transforma a força dele em trabalho útil.2
Isso permite reescrever a fórmula. Se o LLM é só o modelo treinado, tudo o que não é o modelo é harness, e agente = LLM + harness. Em produção, o harness costuma ter cinco responsabilidades: gerenciar o contexto, expor as ferramentas, restringir, verificar e corrigir.2 As duas primeiras são o que já vimos nas seções anteriores. As três últimas são o que separa um demo de um sistema confiável: pedir permissão antes de uma ação perigosa, checar o resultado de cada ferramenta, tentar de novo quando algo falha. No Claude Code, por exemplo, a maior parte do código do harness cuida dessas três, e não de contexto e ferramentas.2
Vale delimitar onde o harness termina. Ele fica dentro do agente e fora do modelo. O que o agente lê e altera, como arquivos, bancos de dados, páginas web e o próprio usuário, não faz parte dele. Isso é o ambiente.2
O peso dessa camada aparece nas estatísticas. No Terminal Bench 2.0, um agente de programação da LangChain passou de 52,8% para 66,5% sem trocar o modelo, só com verificação dos próprios resultados e detecção de ciclos repetitivos.2 No WebArena, um benchmark de tarefas em sites, o mesmo GPT-4o acerta 13,1% sem harness e 54,6% com um.9 Isso não quer dizer que mais harness é sempre melhor. O certo costuma ser o menor que resolve a tarefa, porque cada camada a mais é um lugar a mais para errar.
O ChatGPT e o Claude que você usa já são agentes
Quando alguém diz “perguntei ao ChatGPT” ou “o Claude me respondeu”, a pessoa fala de um aplicativo ou de um site, que está longe de ser o modelo puro. Em volta do modelo há um system prompt, uma memória que atravessa conversas, uma busca na web, um ambiente para executar código, leitura de arquivos enviados pelo usuário e, em alguns produtos, geração de imagens. Há também um loop que decide, a cada pedido, se vale buscar, calcular ou só responder.
Nada disso é segredo: as duas empresas documentam esses recursos. O Claude decide pesquisar na web “quando aplicável” e cita as fontes,14 escreve e roda código para analisar dados enviados15 e guarda uma memória entre conversas, opcional e editável nas configurações.16 O ChatGPT faz o mesmo: busca “com base no que você pergunta”,17 “escreve e executa código Python em seu nome” sobre os arquivos enviados,18 mantém uma memória com o que o usuário pediu para lembrar e o que ele extrai das conversas19 e aceita documentos, planilhas, imagens e áudio anexados.20 Falo aqui só do que o usuário vê na tela. Como cada empresa implementa isso por dentro não está documentado.
Encaixados na fórmula, esses produtos têm as três partes. O contexto é o system prompt, a memória entre conversas e os arquivos enviados. As ferramentas são a busca, a execução de código e a leitura de arquivos. O LLM é o modelo que dá nome ao produto. E o loop está lá: um pedido que dispara uma busca, lê o resultado e só então responde é uma rodada de ReAct completa. A diferença para um agente de programação como o Claude Code está no grau de autonomia. No chat, cada pedido abre uma rodada, a rodada termina na resposta, e o humano decide o passo seguinte. No agente de programação, o loop encadeia dezenas de rodadas até a tarefa acabar, e o humano só entra quando o harness pede permissão.
Um teste simples mostra onde o produto termina e o modelo começa. Chame o mesmo modelo direto pela API, sem ferramentas e sem histórico. Ele não busca nada, não roda código e não sabe o que foi dito na conversa anterior. Responde só com o que aprendeu no treino. Tudo o que o aplicativo faz além disso vem do harness, e é o harness que transforma um gerador de texto em um sistema que age.
O modelo é um componente, o agente é o sistema
Como eu disse no começo, este texto não tentou definir o que é um agente. A proposta era entender do que ele é feito: um contexto bem cuidado, um conjunto pequeno de ferramentas e um loop que sabe quando parar. O modelo é um componente, e todo o resto é harness.
A fórmula também serve para ler produtos. Diante de qualquer coisa que se chame de agente, dá para fazer três perguntas: o que ele enxerga, o que ele consegue fazer e como ele confere se fez certo.2 As três perguntas são sobre o harness. A primeira é o contexto. A segunda, as ferramentas. A terceira é a parte que restringe, verifica e corrige, e costuma ser a resposta mais reveladora, porque é nela que um demo se separa de um sistema confiável.
Por fim, a parte que eu acho mais interessante é que essa divisão não é fixa. Os modelos vão continuar a absorver pedaços do harness. O tool calling é o exemplo mais claro: nos primeiros agentes, o modelo escrevia a chamada em texto livre e o código em volta tentava extrair o nome da ferramenta e os argumentos com expressões regulares. Hoje a decisão de quando chamar, qual ferramenta e com quais argumentos está nos pesos, treinada por aprendizado por reforço, e o harness só executa.2 O que hoje é código em volta, como uma política de retentativa ou uma verificação de resultado, amanhã pode seguir o mesmo caminho. Mas sempre vai existir uma fronteira em que o modelo ainda não é confiável, e é nela que o harness mora.2
Obrigado por ter lido até aqui!
A pintura do topo é “Um filósofo explica o planetário”, de Joseph Wright of Derby (1766). Escolhi a obra porque ela mostra um mecanismo iluminado por dentro, com cada peça à vista, e uma plateia que tenta entender como ele funciona. É o que este texto tentou fazer com o agente.
Notas
-
Wooldridge, M.; Jennings, N. R. Intelligent Agents: Theory and Practice. The Knowledge Engineering Review, 10(2), 1995. https://doi.org/10.1017/S0269888900008122 ↩
-
Li, Bojie. Agentes de IA em Profundidade: Princípios de Design e Prática de Engenharia. Versão 2.0, 3 set. 2026. Tradução para o português do Brasil de Leonardo F. Nascimento. Capítulo 1 (pp. 9–41), seção 4.1 (pp. 134–135) e posfácio (pp. 410–413). Código aberto: https://github.com/bojieli/ai-agent-book ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8 ↩9 ↩10 ↩11 ↩12 ↩13 ↩14 ↩15 ↩16 ↩17 ↩18 ↩19 ↩20 ↩21 ↩22
-
Sumers, T. R.; Yao, S.; Narasimhan, K.; Griffiths, T. L. Cognitive Architectures for Language Agents. Transactions on Machine Learning Research, 2024. arXiv:2309.02427. https://arxiv.org/abs/2309.02427 ↩ ↩2
-
Anthropic. Effective context engineering for AI agents. 29 set. 2025. https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents ↩
-
Sapkota, R.; Roumeliotis, K. I.; Karkee, M. AI Agents vs. Agentic AI: A Conceptual Taxonomy, Applications and Challenges. Information Fusion, 126, 103599, 2025. https://doi.org/10.1016/j.inffus.2025.103599 ↩ ↩2
-
Anthropic. Writing effective tools for agents, with agents. Anthropic Engineering, 11 set. 2025. https://www.anthropic.com/engineering/writing-tools-for-agents ↩ ↩2
-
Xi, Z. et al. The Rise and Potential of Large Language Model Based Agents: A Survey. arXiv:2309.07864, 2023. https://arxiv.org/abs/2309.07864 ↩
-
Vaswani, A. et al. Attention Is All You Need. Advances in Neural Information Processing Systems 30 (NeurIPS 2017). arXiv:1706.03762. https://arxiv.org/abs/1706.03762 ↩
-
Guo, J. et al. From Question Answering to Task Completion: A Survey on Agent System and Harness Design. arXiv:2606.20683, 2026. https://arxiv.org/abs/2606.20683 ↩ ↩2
-
Yao, S. et al. ReAct: Synergizing Reasoning and Acting in Language Models. ICLR 2023. arXiv:2210.03629. https://arxiv.org/abs/2210.03629 ↩
-
Anthropic. Building effective agents. 19 dez. 2024. https://www.anthropic.com/research/building-effective-agents ↩ ↩2
-
Shinn, N. et al. Reflexion: Language Agents with Verbal Reinforcement Learning. NeurIPS 2023. arXiv:2303.11366. https://arxiv.org/abs/2303.11366 ↩
-
Yao, S. et al. Tree of Thoughts: Deliberate Problem Solving with Large Language Models. NeurIPS 2023. arXiv:2305.10601. https://arxiv.org/abs/2305.10601 ↩
-
Anthropic. Claude web search now available globally on all plans. 20 mar. 2025 (atualizado em 27 mai. 2025). https://claude.com/blog/web-search ↩
-
Anthropic. Introducing the analysis tool in Claude.ai. 24 out. 2024. https://claude.com/blog/analysis-tool ↩
-
Anthropic. Bringing memory to Claude. 11 set. 2025. https://claude.com/blog/memory ↩
-
OpenAI. Introducing ChatGPT search. 31 out. 2024 (atualizado em 5 fev. 2025). https://openai.com/index/introducing-chatgpt-search/ ↩
-
OpenAI. Improvements to data analysis in ChatGPT. 16 mai. 2024. https://openai.com/index/improvements-to-data-analysis-in-chatgpt/ ↩
-
OpenAI. Memory and new controls for ChatGPT. 13 fev. 2024 (atualizado em 3 jun. 2025). https://openai.com/index/memory-and-new-controls-for-chatgpt/ ↩
-
OpenAI. Uploading files and audio to ChatGPT, Central de ajuda. Consultada em 11 out. 2026. https://help.openai.com/en/articles/8555545-uploading-files-and-audio-to-chatgpt ↩