Transformers
Como as redes recorrentes levaram ao Transformer e o que faz cada componente da arquitetura.
 Wenderson Melo10 min de leitura
Por que mais um texto sobre Transformers? Por dois motivos. O primeiro é que essa arquitetura está na base dos chats e agentes que usamos todo dia, e quem trabalha com tecnologia ganha muito em entender como ela funciona. O segundo é que faz tempo que eu queria escrever sobre isso.
Toquei nesse assunto de passagem no texto sobre agentes de IA. Lá, contei que quase todos os LLMs atuais são Transformers, uma arquitetura proposta em 2017 que é o estado da arte desde então. Agora a ideia é abrir essa arquitetura e mostrar cada componente do Transformer.
Para entender por que ele tem essa forma, começo pelo que veio antes: as redes recorrentes, o padrão para texto na época. Muitas escolhas do Transformer respondem diretamente aos limites delas.
Antes do Transformer: as redes recorrentes
Texto é uma sequência, e a ordem das palavras muda o sentido: “o cachorro mordeu o homem” e “o homem mordeu o cachorro” têm as mesmas palavras. As redes neurais recorrentes (RNNs) tratam isso com uma leitura em ordem. Elas leem uma palavra por vez e mantêm um vetor, o estado oculto, que é atualizado a cada passo e funciona como a memória do que já foi lido. No fim da frase, esse vetor resume tudo o que a rede viu.
Esse jeito de funcionar traz três limitações.
A primeira é a memória curta. O estado oculto tem tamanho fixo e é reescrito a cada palavra, então a informação do começo da frase se dilui ao longo do caminho. No treino acontece o mesmo com o sinal de erro, que enfraquece a cada passo para trás e quase não chega às primeiras palavras. É o problema conhecido como gradiente que desaparece. Variações como a LSTM e a GRU aliviam isso com portas que controlam o que a memória guarda e o que ela esquece, mas não eliminam o problema.
A segunda é o gargalo, que aparece na tradução. Para traduzir, as RNNs eram usadas em duas partes: um encoder lê a frase de origem e a resume num único vetor, e um decoder gera a tradução a partir dele, com uma palavra de cada vez. A frase inteira, de cinco ou de cinquenta palavras, precisa caber nesse vetor de tamanho fixo.
A terceira é a velocidade. Uma RNN precisa terminar o passo 1 para começar o passo 2, porque o estado de um passo depende do anterior. Numa frase de 50 palavras, são 50 passos em sequência, e a GPU não consegue distribuí-los. O artigo do Transformer aponta isso logo na introdução: essa natureza sequencial “impede a paralelização dentro dos exemplos de treino”.1
A resposta ao gargalo foi a atenção. Em vez de depender só do último vetor, o decoder passa a consultar todos os estados do encoder, um por palavra da frase de origem, a cada palavra que gera. Cada estado recebe um peso conforme o quanto importa naquele momento. Na tradução de “o gato dorme” para “the cat sleeps”, para gerar “cat” o peso de “gato” é alto e os outros são baixos.
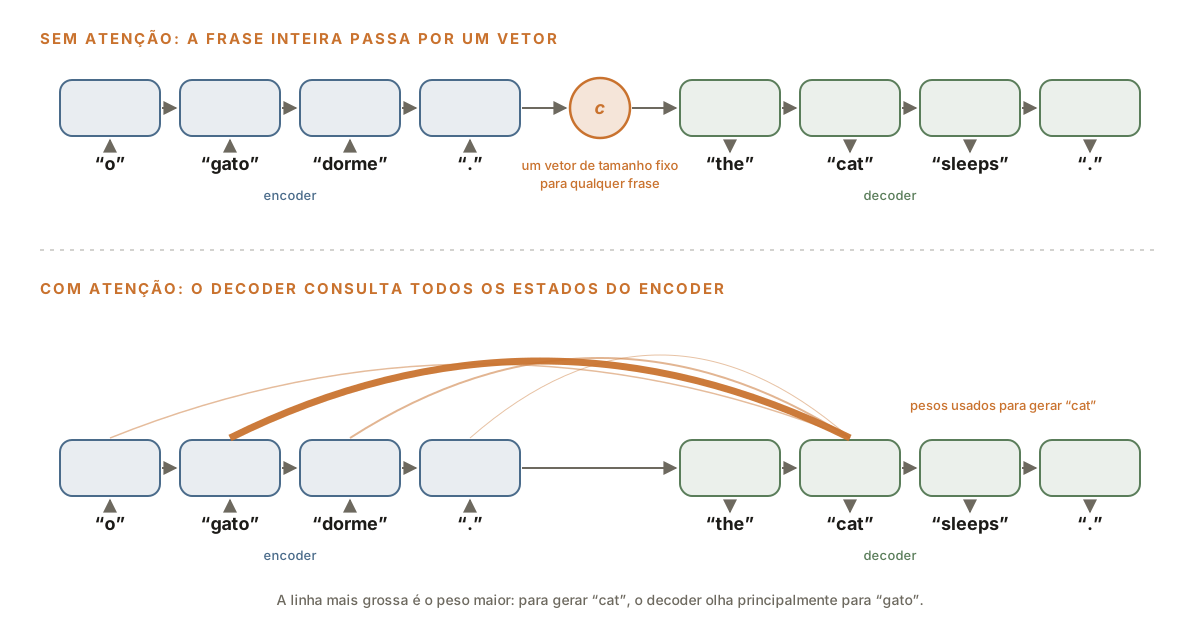
A atenção resolvia o gargalo, mas continuava presa a uma RNN e aos passos em sequência, que a GPU não consegue paralelizar.
Atenção é tudo de que você precisa
Em junho de 2017, oito pesquisadores, quase todos do Google, publicaram Attention Is All You Need.1 O título é a tese: tirar a recorrência e as convoluções e construir o modelo inteiro com atenção. A arquitetura ganhou o nome de Transformer.
A estrutura geral continua a mesma das RNNs de tradução, com um encoder e um decoder. A diferença está dentro de cada um. O encoder é uma pilha de seis camadas iguais (isso na arquitetura original, mas pode-se ter n camadas), e cada camada tem duas partes: autoatenção e uma rede feed-forward. O decoder também tem seis camadas, com uma parte a mais, que olha para a saída do encoder. O encoder não lê a frase palavra por palavra. Todas as palavras entram juntas, e cada camada processa todas ao mesmo tempo.
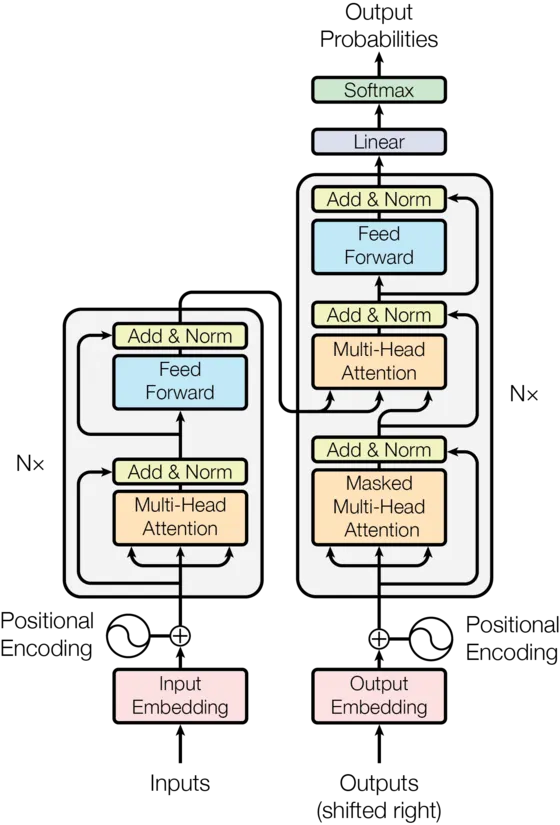
As próximas seções seguem o caminho de uma frase pelo diagrama, de baixo para cima: como as palavras viram vetores, como a atenção as relaciona, o que acontece no resto da camada e como o decoder produz a tradução. No diagrama, o “N×” ao lado de cada pilha indica as seis repetições.
Do texto aos vetores
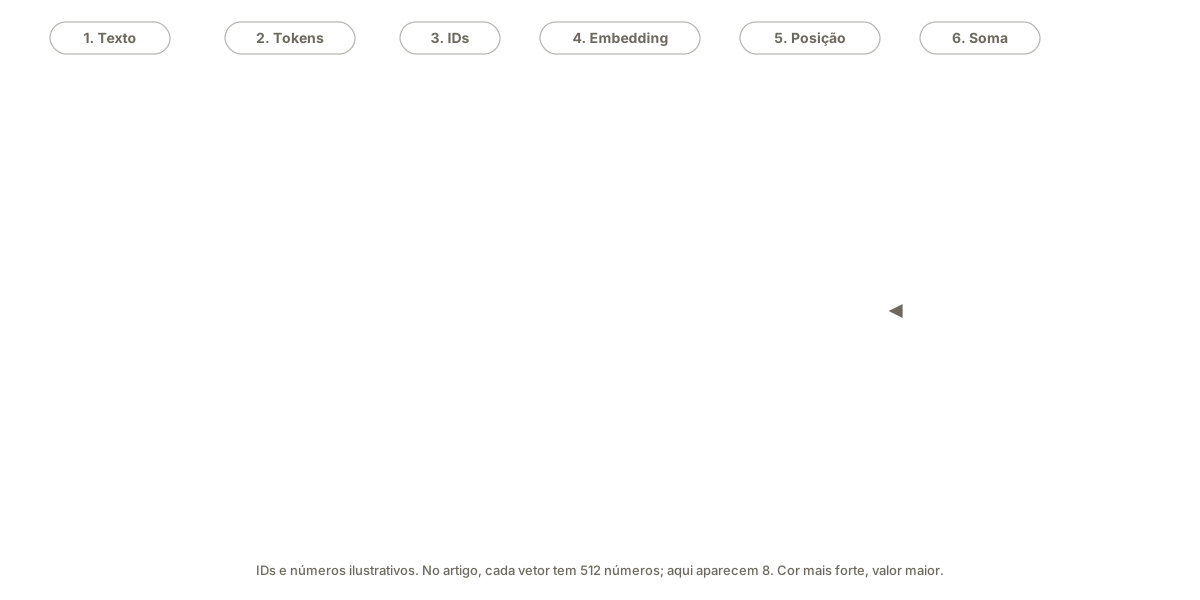
O modelo não lê letras nem palavras inteiras. Antes de tudo, o texto é quebrado em tokens, pedaços de palavra que vêm de um vocabulário fixo. No artigo, o vocabulário de inglês e alemão tinha cerca de 37 mil tokens, compartilhados pelos dois idiomas.1 Uma palavra comum costuma virar um token só, e uma rara vira dois ou três pedaços.
Cada token vira então um embedding: um vetor de 512 números, aprendido no treino. Tokens com sentidos parecidos acabam com vetores próximos. É nesse formato que o token circula por todo o modelo: cada camada recebe 512 números por token e devolve 512 números por token.
Aqui aparece um efeito colateral de abandonar a recorrência. A RNN sabia a ordem das palavras porque lia uma de cada vez. A atenção, sozinha, trata a frase como um conjunto: em “o cachorro mordeu o homem” e “o homem mordeu o cachorro”, ela não tem como saber quem veio antes. Para devolver a ordem ao modelo, o Transformer soma a cada embedding uma codificação posicional, um vetor que depende só da posição do token na frase.
No artigo, esse vetor é feito de senos e cossenos de frequências diferentes. Cada posição recebe um padrão único, como os ponteiros de um relógio que giram em velocidades diferentes, e a distância entre duas posições vira uma relação simples entre os padrões. Os autores também testaram aprender esses vetores no treino, como os embeddings, e os resultados foram quase idênticos. Ficaram com os senos e cossenos porque eles talvez permitam ao modelo lidar com frases mais longas que as vistas no treino.1
A animação abaixo mostra o caminho completo, da frase aos vetores que entram na primeira camada.
Autoatenção: queries, keys e values
A autoatenção é o mecanismo central do Transformer. Ela deixa cada token olhar para os outros da mesma frase e decidir quais importam para o seu sentido. Pense em “banco” nas frases “sentei no banco da praça” e “fui ao banco sacar dinheiro”. O embedding é o mesmo nas duas, porque vem da mesma linha da tabela. Depois da autoatenção, cada “banco” carrega algo das palavras vizinhas (“praça” num caso, “dinheiro” no outro), e os dois vetores passam a ser diferentes.
Com pronomes acontece o mesmo. Em “o animal não atravessou a rua porque ele estava cansado”, o vetor de “ele” precisa puxar informação de “animal”, e não de “rua”.
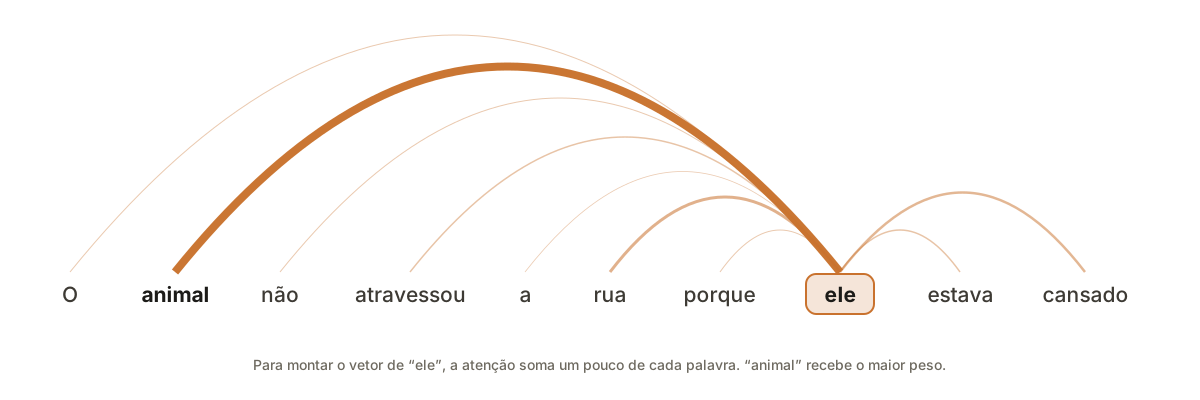
Para isso, cada token gera três vetores a partir do seu embedding, cada um por uma matriz aprendida no treino:
- a query é o que o token procura;
- a key é o que o token oferece;
- o value é o conteúdo que ele entrega.
A conta tem quatro passos: comparar a query com cada key (um produto escalar), dividir o resultado pela raiz da dimensão das keys para manter os números numa escala estável, passar por um softmax, que transforma os números em pesos que somam 1, e somar os values com esses pesos. A animação abaixo mostra cada passo para o token “ele”.
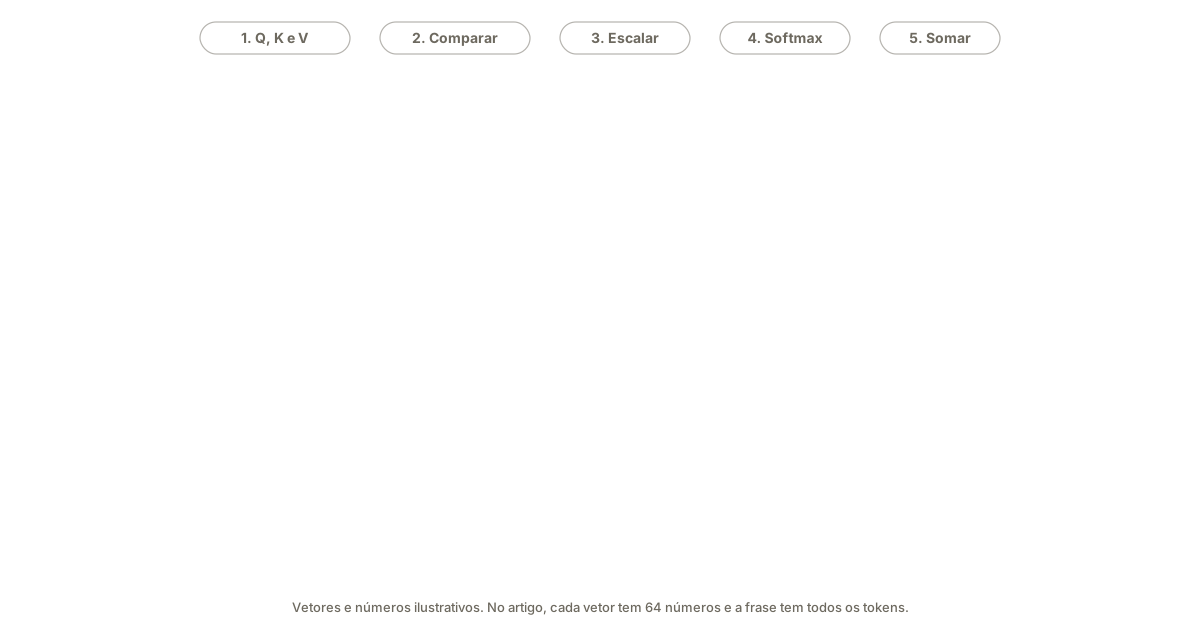
O artigo escreve assim:1
Atenção(Q, K, V) = softmax(Q · Kᵀ / √dₖ) · VEsse mecanismo resolve dois dos limites da RNN que vimos no início. Como a conta de cada token não depende da conta dos outros, a frase inteira vira uma multiplicação de matrizes, e a GPU calcula tudo em paralelo. E como cada token consulta todos os outros diretamente, a distância entre duas palavras deixa de importar.1
Atenção multi-cabeça
Como vimos, uma atenção sozinha calcula um único conjunto de pesos por token. Só que um token costuma precisar de várias informações ao mesmo tempo. Em “o animal não atravessou a rua porque ele estava cansado”, “ele” precisa saber, por exemplo, a quem se refere e a que verbo se liga. Com uma atenção só, o token precisa dividir o peso entre as duas palavras, e o resultado vira uma média das duas.
A solução do artigo é rodar várias atenções em paralelo, cada uma com as próprias matrizes de query, key e value. Cada uma dessas atenções é uma cabeça. O Transformer base usa 8 cabeças, e as saídas delas são juntadas em um único vetor por token, que segue para o resto da camada.1
As cabeças não recebem uma função definida. Cada uma aprende no treino a olhar para um tipo de relação. Nos exemplos do artigo, algumas ligam “making” a “more difficult” numa frase longa, e outras parecem identificar a que palavra um pronome se refere.1
O resto da camada
Além da atenção multi-cabeça, cada camada tem uma rede feed-forward. Na atenção, os tokens trocam informação entre si. Na feed-forward, cada token é processado separadamente, sem olhar para os outros, e todos passam pela mesma rede.1
A atenção e a feed-forward são seguidas por um passo que o diagrama do artigo chama de Add & Norm, e que mantém fácil o treino de muitas camadas empilhadas. O Add, a conexão residual, soma o vetor que entrou em cada uma ao vetor que saiu, e assim elas só precisam aprender o que acrescentar. O Norm, a normalização de camada, mantém os números numa escala estável, sem crescer nem encolher de uma camada para a outra.1
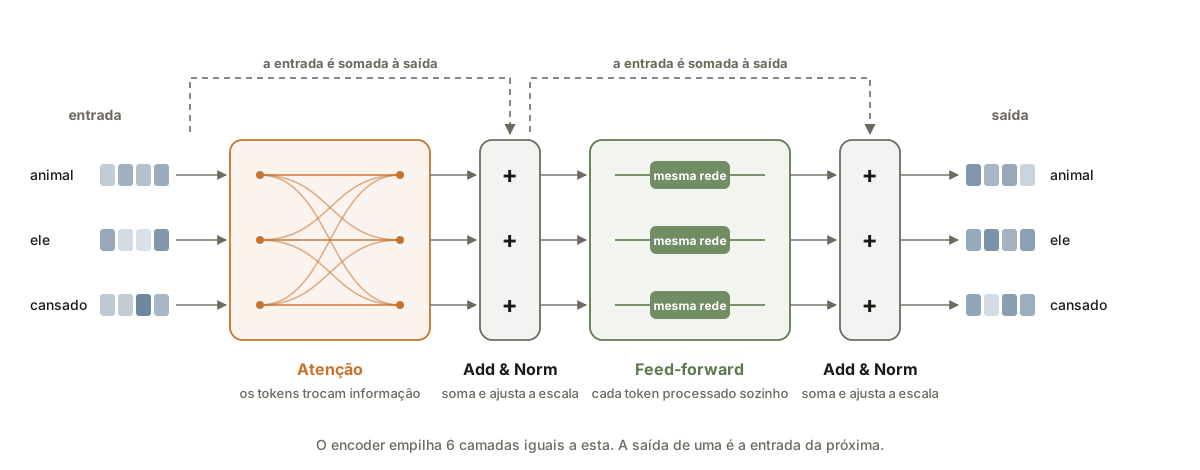
O encoder empilha seis camadas como essa, e a saída de uma é a entrada da próxima. No fim, cada token da frase de origem tem um vetor que reúne o seu sentido e o contexto da frase inteira. São esses vetores que o decoder vai consultar.
O decoder e a próxima palavra
O decoder gera a tradução uma palavra de cada vez, e cada palavra escolhida volta como entrada para a próxima. Esse modo de gerar se chama autorregressivo, o mesmo do decoder de uma RNN. Cada camada do decoder tem três partes.
A primeira é uma autoatenção mascarada. Ela funciona como a do encoder, mas cada token só olha para os anteriores, e as posições futuras ficam com peso zero.1 Sem a máscara, o modelo veria no treino a palavra que deveria prever e aprenderia só a copiá-la.
A segunda parte é a atenção cruzada, em que o decoder consulta o encoder. As queries vêm do decoder, e as keys e os values vêm dos vetores que o encoder produziu.1 Com ela, cada palavra da tradução busca na frase de origem o que precisa, o mesmo papel da atenção que já era usada com as RNNs.
A terceira parte é a feed-forward, e as três são seguidas por Add & Norm, como no encoder. Depois da sexta camada, o vetor da última posição passa por uma camada linear (mais uma multiplicação por matriz) e por um softmax, que dão a probabilidade de cada token do vocabulário ser o próximo. A animação abaixo mostra esse ciclo na tradução de “o gato dorme”.
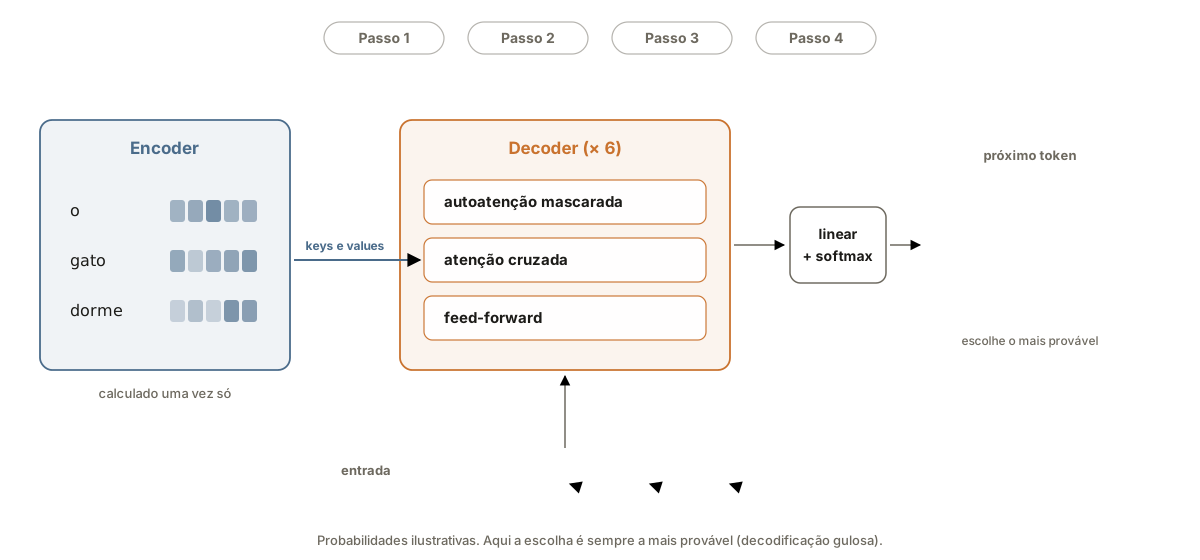
Na animação, o decoder escolhe sempre o token mais provável. Essa estratégia se chama decodificação gulosa (greedy) e é a mais simples, mas uma escolha que parece boa num passo pode levar a uma frase pior nos seguintes. O artigo usa beam search, que acompanha as quatro traduções parciais mais prováveis ao mesmo tempo e, no fim, fica com a melhor.1 Nos dois casos, a geração para quando o modelo escolhe o token de fim de frase.
O que o artigo mostrou
O artigo testou o Transformer em tradução, a tarefa em que as RNNs com atenção e, mais recentemente, as redes convolucionais tinham os melhores resultados. A qualidade é medida pelo BLEU, uma métrica que compara a tradução da máquina com traduções feitas por pessoas (quanto maior, melhor).
De inglês para alemão, no WMT 2014, o Transformer big chegou a 28,4, mais de 2 pontos acima dos melhores resultados anteriores, inclusive dos que combinavam vários modelos. De inglês para francês, chegou a 41,8 com 3,5 dias de treino em oito GPUs, uma fração do custo dos melhores modelos da época. O modelo base, menor, treinou em 12 horas.1 Os autores também aplicaram a arquitetura, com poucas mudanças, à análise sintática do inglês, para mostrar que ela servia para mais do que tradução.
A atenção também tem um preço. Como cada token se compara com todos os outros, o custo cresce com o quadrado do tamanho do texto, e dobrar o texto quadruplica as comparações. Nas frases de algumas dezenas de tokens usadas no artigo, isso era barato.1 Com textos cada vez maiores, esse custo passou a pesar.
Cada passo resolveu o anterior
No fim, cada etapa resolveu um limite da anterior. A RNN deu memória à rede, mas uma memória curta. O encoder e o decoder recorrentes traduziam, mas espremiam a frase num vetor. A atenção tirou o gargalo, mas ainda dependia de uma RNN lenta. O Transformer manteve a atenção e tirou o resto.
E ele também deixou os seus limites. Na geração, a cada token novo, o decoder precisaria recalcular as keys e os values de todos os tokens anteriores, mesmo que eles não mudem. O cache KV guarda esses valores e evita o retrabalho. Como ele funciona provavelmente vai ganhar um texto próprio no futuro.
Obrigado por ter lido até aqui!
A pintura do topo é “A Escola de Atenas”, de Rafael (1509–1511). Pintada no auge do Renascimento, ela reúne os pensadores gregos que fundaram boa parte da filosofia ocidental, assim como o artigo de 2017 virou a base de quase tudo o que veio depois em IA. Na cena, eles conversam em grupos, e cada um está voltado para quem importa para ele naquele momento. É uma boa imagem para a autoatenção, em que cada token olha para os outros e dá mais peso aos que importam para ele.
Notas
-
Vaswani, A.; Shazeer, N.; Parmar, N.; Uszkoreit, J.; Jones, L.; Gomez, A. N.; Kaiser, Ł.; Polosukhin, I. Attention Is All You Need. Advances in Neural Information Processing Systems 30 (NeurIPS 2017). arXiv:1706.03762. https://arxiv.org/abs/1706.03762 ↩ ↩2 ↩3 ↩4 ↩5 ↩6 ↩7 ↩8 ↩9 ↩10 ↩11 ↩12 ↩13 ↩14 ↩15